 Nos formations
 Nos certifications
 Contact

Visibilité dans ChatGPT : j’ai lu le robots.txt de 50 sites français

Depuis un an, la question qu’on me pose le plus souvent sur le référencement a changé. Avant, c’était comment passer devant un concurrent sur Google. Aujourd’hui, c’est comment faire pour que ChatGPT cite mon site. La réponse commence rarement par le contenu. Elle commence par un fichier texte de deux kilo-octets que presque personne n’ouvre.
Début novembre 2026, j’ai lu le robots.txt de 50 sites français : dix titres de presse, dix médias marketing et tech, dix sites e-commerce, dix éditeurs de logiciels, dix sites de voyage. Quarante-trois fichiers étaient lisibles sans se faire passer pour un navigateur. Ce que j’y ai trouvé ressemble peu à ce que raconte la littérature sur le sujet.
Trois robots par éditeur, un seul décide si vous êtes cité
Première chose à comprendre avant d’ouvrir son fichier : chaque éditeur d’IA fait passer plusieurs robots qui ne servent pas à la même chose.
Chez OpenAI, la documentation des robots en distingue plusieurs. GPTBot récupère des pages pour l’entraînement des modèles. OAI-SearchBot sert à faire apparaître les sites dans la recherche de ChatGPT. ChatGPT-User va chercher une page précise quand un utilisateur pose une question qui l’exige. OpenAI précise que les réglages sont indépendants : vous pouvez autoriser OAI-SearchBot et refuser GPTBot, ce qui revient à dire oui à la citation et non à l’entraînement.
Chez Perplexity, la documentation sépare de la même façon. PerplexityBot sert à référencer et à lier les sites dans les résultats. L’éditeur écrit explicitement qu’il n’est pas utilisé pour collecter du contenu destiné aux modèles de fondation. Perplexity-User, lui, va chercher la page quand quelqu’un pose la question. Perplexity indique que ce récupérateur ignore généralement les règles du robots.txt, puisque la demande vient d’un humain.
Autrement dit, bloquer GPTBot et bloquer OAI-SearchBot sont deux décisions commerciales différentes. La première protège vos textes. La seconde vous retire des réponses.
La presse ferme sa rédaction et laisse ouverte sa boutique
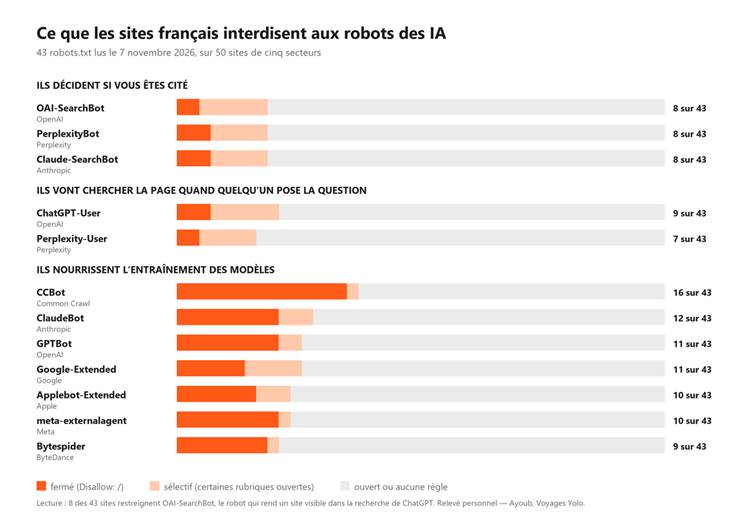
Sur les 43 fichiers lus, 19 restreignent au moins un robot d’entraînement. Dix seulement restreignent un robot de citation. Et sur ces dix, neuf sont des titres de presse.
Le détail est plus parlant que le total. Sept de ces dix sites ne ferment pas tout : ils posent un Disallow: / sur les robots de recherche des IA, puis rouvrent quelques rubriques avec des Allow. Voici lesquelles, relevées telles quelles.
Les Échos ferme le site à OAI-SearchBot et à PerplexityBot. Sa rubrique de contenus de marque, /thema, reste ouverte. La Tribune ferme le même groupe de robots et garde /guide-achat/, /partenaires-603/ et /l-instant-selection-405/. L’Usine Digitale garde /publi-redactionnel/, /nos-webinars/ et /cherche-talents-numeriques/. Le Parisien laisse passer Perplexity sur /guide-shopping/. Ouest-France conserve /shopping/, /tourisme/ et /publi-info/ en plus de ses éditions régionales. Le Figaro ouvre entre autres /voyages, /culture, /style, /beaute, /joaillerie, /horlogerie et /bons-plans. 20 Minutes garde une quinzaine de rubriques, dont /guide-achat/, /conso, /high-tech/ et /horoscope/.
Trois titres seulement ferment sans exception : Libération, France TV Info et Le Monde, ce dernier uniquement sur le robot de recherche d’Anthropic. Et toutes les exceptions ne sont pas commerciales : Le Figaro laisse aussi /elections/resultats accessible, ce qui relève du service public de l’information.
La tendance reste nette. Neuf des dix titres de presse lus restreignent au moins un robot de citation. Sept d’entre eux gardent ouvertes des rubriques vendues à des annonceurs ou génératrices d’affiliation, pendant que leur production journalistique reste fermée.
Pour un annonceur, la conséquence est concrète. Si vous achetez un publi-rédactionnel dans un grand titre français, cette page fait peut-être partie du peu que ChatGPT et Perplexity peuvent encore lire et citer sur ce domaine. C’est un critère qui ne figure dans aucun média-kit. Il se vérifie en trente secondes.
Ce que les sites français interdisent aux robots des IA. Relevé personnel sur 43 robots.txt, novembre 2026.
Hors presse, la porte est grande ouverte
Je m’attendais à trouver des entreprises en train de se fermer les portes par imitation. J’ai trouvé l’inverse. Hors presse, aucun site de mon échantillon ne restreint un robot de citation. Zéro sur six en e-commerce, zéro sur dix chez les éditeurs de logiciels, zéro sur neuf en voyage. Vingt des 43 sites n’ont aucune règle nominative visant une IA, ce qui les laisse ouverts par défaut.
Le robot le plus bloqué n’est d’ailleurs ni celui d’OpenAI ni celui de Google. C’est CCBot, le robot de Common Crawl, restreint par 16 sites sur 43. Common Crawl est l’archive publique dans laquelle les premiers modèles ont puisé. C’est la ligne qui circulait dans tous les articles de 2023. Elle est restée dans les fichiers bien après que la question s’est déplacée ailleurs.
C’est la vraie leçon du relevé pour une entreprise. Le danger tient à l’imitation : recopier le robots.txt d’un éditeur de presse sans avoir ses raisons. Un journal qui négocie des licences et vend ses archives a un intérêt à fermer. Une marque qui cherche à être recommandée paie le même prix sans la contrepartie.
Le blocage qui ne se voit pas dans le robots.txt
Un fichier parfaitement réglé ne garantit rien, parce que la décision se prend souvent ailleurs.
Google le dit dans sa page destinée aux éditeurs, AI features and your website, où la première bonne pratique listée consiste à s’assurer que l’exploration est autorisée dans le robots.txt et par le CDN ou l’hébergement. Perplexity va plus loin et publie dans sa documentation les règles Cloudflare à écrire pour laisser passer ses robots, avec les plages d’adresses IP à jour.
J’en ai eu la démonstration pendant ce relevé. Sept sites sur 50 n’ont pas répondu, dont six par un refus 403 opposé à un agent identifié qui demandait un simple fichier texte public. Leur robots.txt n’interdisait rien. Leur protection anti-robots, si. Un pare-feu applicatif qui filtre sur la réputation ou sur le débit ne fait pas la différence entre un aspirateur de contenu et le robot qui irait chercher votre page pour répondre à un client.
La vérification tient en une ligne de commande sur vos logs serveur : cherchez les passages de OAI-SearchBot, de PerplexityBot et de ClaudeBot sur les trente derniers jours. S’ils sont absents alors que votre robots.txt les autorise, le problème est dans la couche au-dessus.
llms.txt : onze sites sur cinquante, Google répond non
J’ai aussi regardé qui publiait un fichier llms.txt, ce sommaire en markdown censé aider les modèles à comprendre un site. Onze sites sur 50 en ont un. Ils viennent presque tous du même monde : des éditeurs de logiciels et des acteurs du voyage.
Google a tranché la question dans la même page que plus haut, en écrivant qu’il n’y a pas besoin de créer de nouveaux fichiers lisibles par machine, ni de fichiers texte destinés aux IA, ni de balisage particulier pour apparaître dans ses fonctionnalités d’IA. Il ajoute qu’aucune donnée structurée schema.org spécifique n’est nécessaire. La formulation est inhabituellement directe pour de la documentation Google.
Le fichier coûte une heure à produire et ne casse rien. Le présenter comme un levier de visibilité relève du pari sur l’avenir, pas de la mesure.
Ce qui rend un passage reprenable
Une fois la plomberie vérifiée, la question devient éditoriale. Sur ce terrain il existe un travail de recherche sérieux plutôt que des avis.
L’article fondateur du domaine, GEO: Generative Engine Optimization, publié par une équipe de Princeton en novembre 2023, a testé des modifications de contenu sur un banc d’essai de requêtes et mesuré leur effet sur la visibilité dans les réponses génératives. Leurs trois méthodes les plus efficaces sont de citer des sources, d’ajouter des propos d’experts et de remplacer les formulations vagues par des chiffres. Elles améliorent la visibilité de 30 à 40 % sur la première métrique des auteurs et de 15 à 30 % sur la seconde. Pendant ce temps, le bourrage de mots clés hérité du SEO classique fait 10 % moins bien que de ne rien faire. Les auteurs précisent que l’efficacité varie fortement selon le domaine traité.
Ça rejoint la façon dont Google décrit le fonctionnement de ses propres réponses. Sa documentation parle d’une technique de query fan-out, où le moteur éclate la question en plusieurs recherches sur des sous-sujets avant de composer la réponse — un mécanisme détaillé dans notre analyse sur le SEO en 2026 entre IA, vectorisation et logique sémantique. Une page qui traite une question en bloc est moins exploitable qu’une page où chaque sous-question a son paragraphe autonome, avec sa date, son montant et sa source nommée.
Sur mon propre site, les pages que les moteurs reprennent le plus volontiers sont celles-là. Mon guide sur les permis de zone frontalière au Kirghizistan est découpé en questions réelles, avec les tarifs, les délais et ce qui a changé dans l’année. Chaque bloc se tient tout seul si on l’extrait du reste.
Un dernier réglage mérite une vérification, parce qu’il annule tout le reste en silence. Google indique que pour figurer comme lien d’appui dans AI Overviews ou AI Mode, une page doit être indexée et éligible à l’affichage d’un extrait. Les balises nosnippet, data-nosnippet, max-snippet et noindex limitent cet affichage. Une directive max-snippet posée il y a trois ans contre les agrégateurs vous coûte aujourd’hui votre place dans les réponses.
Mesurer sans acheter un outil
La mesure est le point faible de tout le sujet. Autant le dire franchement.
Google précise que les sites apparaissant dans ses fonctionnalités d’IA sont comptés dans le trafic global de la Search Console, dans le rapport Performances, type de recherche « Web ». Aucune ventilation séparée. Vous voyez le total, pas la part.
Trois mesures restent accessibles à tout le monde. Le trafic de référence depuis chatgpt.com, perplexity.ai et les domaines de Copilot, dans votre outil d’analyse d’audience : le volume est faible, mais la tendance se lit. Les logs serveur, pour savoir quels robots passent et sur quelles pages. Et une liste figée d’une vingtaine de questions que vous reposez chaque mois aux trois ou quatre moteurs, en notant à la main qui est cité — une méthode pragmatique pour suivre sa visibilité dans les réponses de ChatGPT et Perplexity. C’est artisanal, ça prend une heure par mois.C’est aussi la seule donnée que personne ne peut vous retirer.
Les cinq vérifications, dans l’ordre
- Ouvrez votre robots.txt et cherchez OAI-SearchBot, PerplexityBot et Claude-SearchBot. Aucune règle à leur nom, c’est une bonne nouvelle : vous êtes ouvert.
- Regardez vos logs sur trente jours pour confirmer que ces robots passent vraiment. S’ils sont absents, allez voir votre CDN ou votre pare-feu applicatif.
- Cherchez nosnippet et max-snippet dans vos balises et vos en-têtes HTTP.
- Relevez votre trafic de référence depuis les domaines d’IA, pour avoir un point de départ daté.
- Travaillez le contenu en dernier, quand les quatre points précédents sont au vert, en appliquant des méthodes concrètes pour adapter son SEO à ChatGPT.
Les quatre premières vérifications prennent une matinée et ne se refont qu’une fois par an. La cinquième ne s’arrête jamais.
Reste une question que mon relevé ne tranche pas. Les éditeurs qui ouvrent aujourd’hui leur rubrique shopping aux moteurs IA tout en fermant leur rédaction tiendront-ils cette ligne quand les licences seront signées ? La réponse se lira dans leurs robots.txt. Elle est publique.
Méthode
Les 50 sites ont été interrogés le 7 novembre 2026 sur leur seul fichier robots.txt public, avec un agent identifié qui annonçait son nom. Les directives ont été regroupées par user-agent comme le fait un robot d’exploration, la règle nominative l'emportant sur la règle générique. Un Disallow: / accompagné de règles Allow est compté comme restriction partielle plutôt que comme blocage. Sept sites n’ont pas pu être lus, dont six qui ont opposé un refus 403.
À propos de l’auteur
Ayoub est le fondateur de Voyages Yolo, un média de voyage indépendant qu’il fait vivre au référencement naturel. Il écrit sur le SEO et sur la visibilité dans les moteurs de réponse génératifs.
Invité


