Nos formations
 Nos certifications
 Contact

SEO 2026 : la recherche entre IA, vectorisation et logique sémantique
L’optimisation pour les moteurs de recherche… et de réponses, en 2026 a complètement évolué par rapport à ce que nous connaissions il y a quelques années. Le SEO traditionnel, qui reposait sur des mots-clés, des maillages et des balises, cède la place à une approche plus nuancée et conceptuelle : le SEO pour les IA génératives. Bref, ce qu’on appelle communément, désormais, l’AEO ou GEO…
La fin du SEO d’hier : pourquoi les anciennes méthodes ne fonctionnent plus
Il y a quelques mois, un article de La Presse mettait en garde contre la disparition progressive du web « tel que nous le connaissions ». Une réaction peut-être un peu hâtive, car ce changement était inévitable. Ceux qui pratiquent le SEO depuis plus de 15 ans ont déjà traversé plusieurs révolutions (Panda, Penguin, RankBrain). Aujourd’hui, le changement est plus profond : ce n’est pas seulement l’algorithme qui évolue, mais la nature même de la recherche. Ce bouleversement s’impose avec l’émergence de modèles comme Gemini, qui ne voient plus le web comme un simple annuaire de liens, mais comme un espace sémantique vectoriel.
Deux réflexes cohabitent encore dans les équipes SEO. Le premier consiste à empiler les occurrences du mot-clé en espérant que ça suffise. Le second part de la façon dont un modèle de langage va lire, découper et réutiliser la page. En 2026, le second l'emporte, mais pas toujours pour les raisons qu’on lit partout.
Le netlinking ne disparaît pas, il se déplace
Les PBN et les annuaires existent toujours. Ils produisent simplement de moins en moins d’effet, pour un risque qui, lui, n’a pas baissé. Ce qui tient dans la durée, c’est un lien posé dans un paragraphe qui traite réellement du sujet, entouré d’entités identifiables : une marque, une ville, un nom propre, un chiffre daté.
La raison est mécanique. Quand un moteur découpe une page en passages pour les vectoriser, un lien coincé dans un pied de page ou une liste de partenaires se retrouve dans un passage qui ne parle de rien. Le même lien placé au milieu d’un développement argumenté hérite du contexte de ce développement. La Domain Authority n’est pas morte pour autant, elle est devenue un critère parmi d’autres, et plus le premier.
Les données structurées servent, mais pas à ce qu’on croit
Google a été explicite en juillet 2026 : aucun balisage particulier n’est requis pour apparaître dans AI Mode ou dans les AI Overviews. Pas de schema magique. La seule exigence est que les données structurées correspondent au contenu visible de la page.
Ce qui compte vraiment, c’est la structure du contenu lui-même. Un tableau comparatif, une définition en deux phrases, une liste de critères : ce sont des blocs autonomes, extraits et cités sans reformulation. Un pavé de 800 mots sans respiration ne donne aucune prise. Le test est simple : sortez n’importe quel paragraphe de son contexte. S’il reste compréhensible, il est exploitable.
Ce qui se passe entre la requête et votre page : NLR, RAG et embeddings
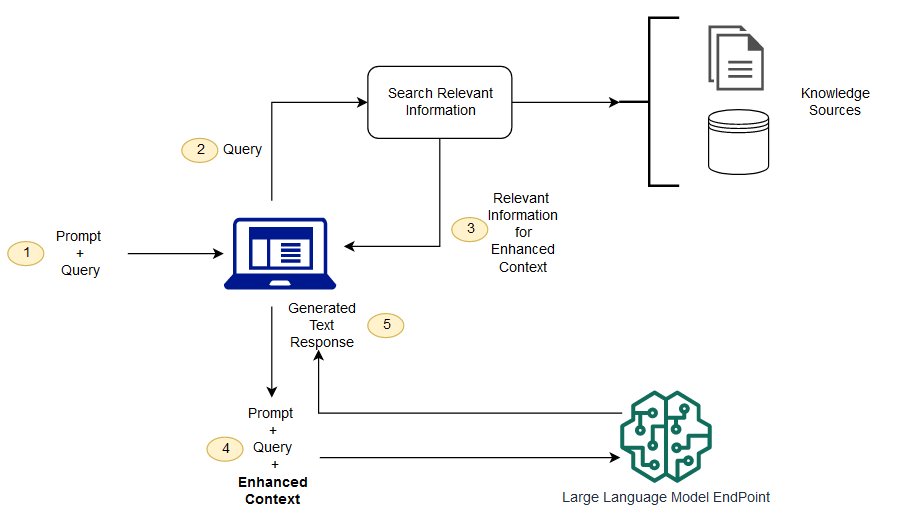
La recherche classique associait une requête à des documents. Le fonctionnement actuel passe par du RAG : la requête devient un vecteur, comparé à des passages eux-mêmes vectorisés en amont, et les meilleurs candidats servent de matière première à une réponse générée. La similarité vectorielle a remplacé le TF-IDF comme mesure de proximité.
Le détail qui change tout : ce ne sont plus des pages qui sont sélectionnées, ce sont des passages. Une page moyenne avec une excellente section peut être citée. Une bonne page sans section nette peut ne jamais l’être.
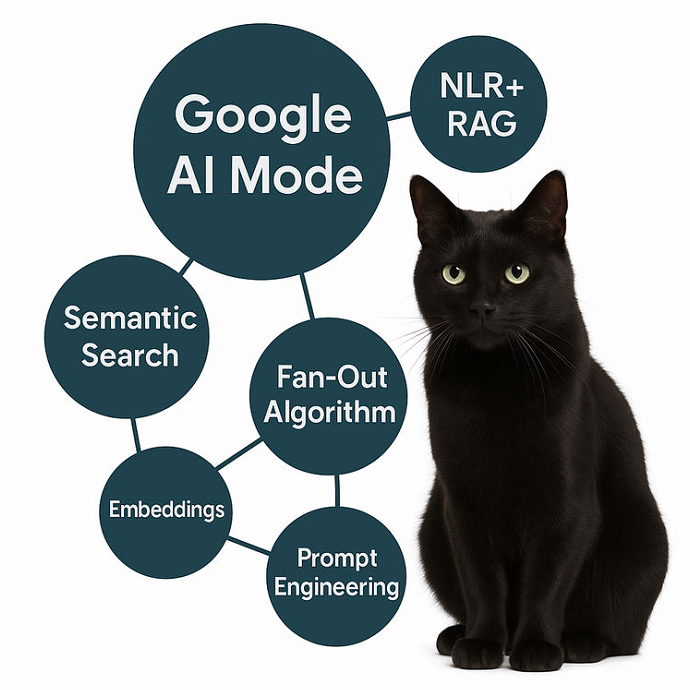
Le query fan-out
Posez « quel ERP pour une PME ? » et le système ne cherche pas cette phrase. Il lance en parallèle une série de recherches dérivées : budget, fonctionnalités, intégration, support, sécurité. Chacune ramène ses propres passages. La réponse finale assemble des sources qui n’ont jamais été classées ensemble sur une page de résultats.
La conséquence est directe pour la production de contenu. Une page qui ne traite que la question de surface ne participe qu’à une fraction du fan-out. Il faut couvrir les sous-questions, une par titre, avec la réponse dans les deux premières phrases et les preuves ensuite.
Une parenthèse sur llms.txt
La question revient à chaque réunion, autant y répondre. Google ignore le fichier : sa documentation de juillet 2026 indique qu’il n’aide ni ne pénalise, y compris dans les fonctionnalités génératives. Les études d’adoption disponibles ne montrent aucun effet mesurable sur les citations. Rien n'empêche de le publier si un agent identifié l’exploite, mais pas au détriment de l’indexabilité, du maillage ou du contenu.
Du document au passage : la granularité comme critère de sélection
Aujourd’hui, les intelligences artificielles ne se contentent plus de choisir des pages entières, mais se concentrent sur des passages spécifiques. Pour qu’une unité de contenu soit efficace, elle doit :
- Présenter une information claire (comme un fait, une date ou un nom propre)
- Être bien structurée
- Être liée à des entités reconnaissables (personnes, marques, lieux)
C’est pourquoi nous envisageons désormais le contenu comme une série de modules sémantiques plutôt que comme de simples articles linéaires.
L’IA reformule vos questions
Prenons un exemple de question : Quel ERP pour une PME ? L’IA va automatiquement décomposer cette question en sous-requêtes : budget, fonctionnalités, support, sécurité, intégration. Chacune de ces sous-questions est vectorisée, comparée à des passages pertinents, puis intégrée dans un prompt contextuel. Le résultat est une réponse composite, provenant de multiples sources, qui reste cohérente.
Ce processus que l’on appelle Fan-Out Embedding Expansion — révolutionne le SEO : il est désormais essentiel de répondre à toutes les sous-questions implicites en utilisant des formats clairs, bien balisés et centrés sur les entités.
L’ingénierie de la pertinence : une nouvelle discipline du SEO
Le métier évolue. L’expert SEO se transforme en architecte de la donnée sémantique. Il n’écrit plus seulement pour le lecteur, mais aussi pour un modèle. Il collabore avec :
- Des graphes de concepts (comme Diffbot)
- Des encodages de phrases (comme SentenceTransformer)
- Des formats facilement identifiables : tableaux, listes, définitions
- Le contenu prêt pour l’IA est un contenu modulaire, structuré, basé sur des entités et vectorisable.
Requêtes custom et profils utilisateurs vectorisés
Le SEO pour LLMs devient personnel. devient de plus en plus personnel. Deux utilisateurs différents ne recevront pas les mêmes réponses, car leur embedding utilisateur influence la recherche : historique, géolocalisation, comportement, préférences.
La stratégie SEO doit donc se concentrer sur des territoires sémantiques cohérents : être présent sur les entités clés, dans des formats pertinents, pour tous les types de profils.
Le métier se déplace
Le référenceur passe une part croissante de son temps sur des questions d’architecture de l’information : quelles entités doivent apparaître, sous quel format, dans quel ordre, appuyées par quelles preuves. Les outils suivent, graphes de concepts et encodeurs de phrases, mais ce sont des accessoires. Le fond du travail n’a pas tellement bougé en quinze ans : écrire des choses vraies, vérifiables et bien rangées. Ce sont les destinataires qui ont changé.
Comment tracker sa présence dans AI Mode ?
- Tester les requêtes avec différents profils (incognito, Gmail actif, etc.)
- Observer les passages repris en mode IA (via SGE ou des outils comme PromptLayer)
- Utiliser LangChain, RAGStack ou LlamaIndex pour simuler le comportement d’un moteur IA
- Travailler les embeddings de contenu avec des outils comme Gemini Embedder ou MPNet